Hoe tekst in tokens wordt opgeknipt
Het opknippen van tekst in tokens heet tokenisatie. Grofweg werkt het zo:
- Een kort, gewoon woord is meestal 1 token — bijvoorbeeld
boom. - Een langer woord wordt vaak in meer tokens opgeknipt — bijvoorbeeld
onwaarschijnlijkin 3 stukjes:on·waarschijn·lijk. - Ook spaties en leestekens tellen mee als (deel van) een token.
Let op: dit zijn illustraties, geen vaste regels. Hoe een woord precies wordt opgeknipt verschilt per model, dus het exacte aantal tokens ligt niet vast.
Wat je verstuurt én wat je terugkrijgt telt mee
Niet alleen wat je náár de AI stuurt telt als tokens, maar ook wat je terugkrijgt. Je vraag wordt in tokens omgezet, de AI denkt na, en produceert zelf weer tokens die als antwoord teruggezet worden in tekst.
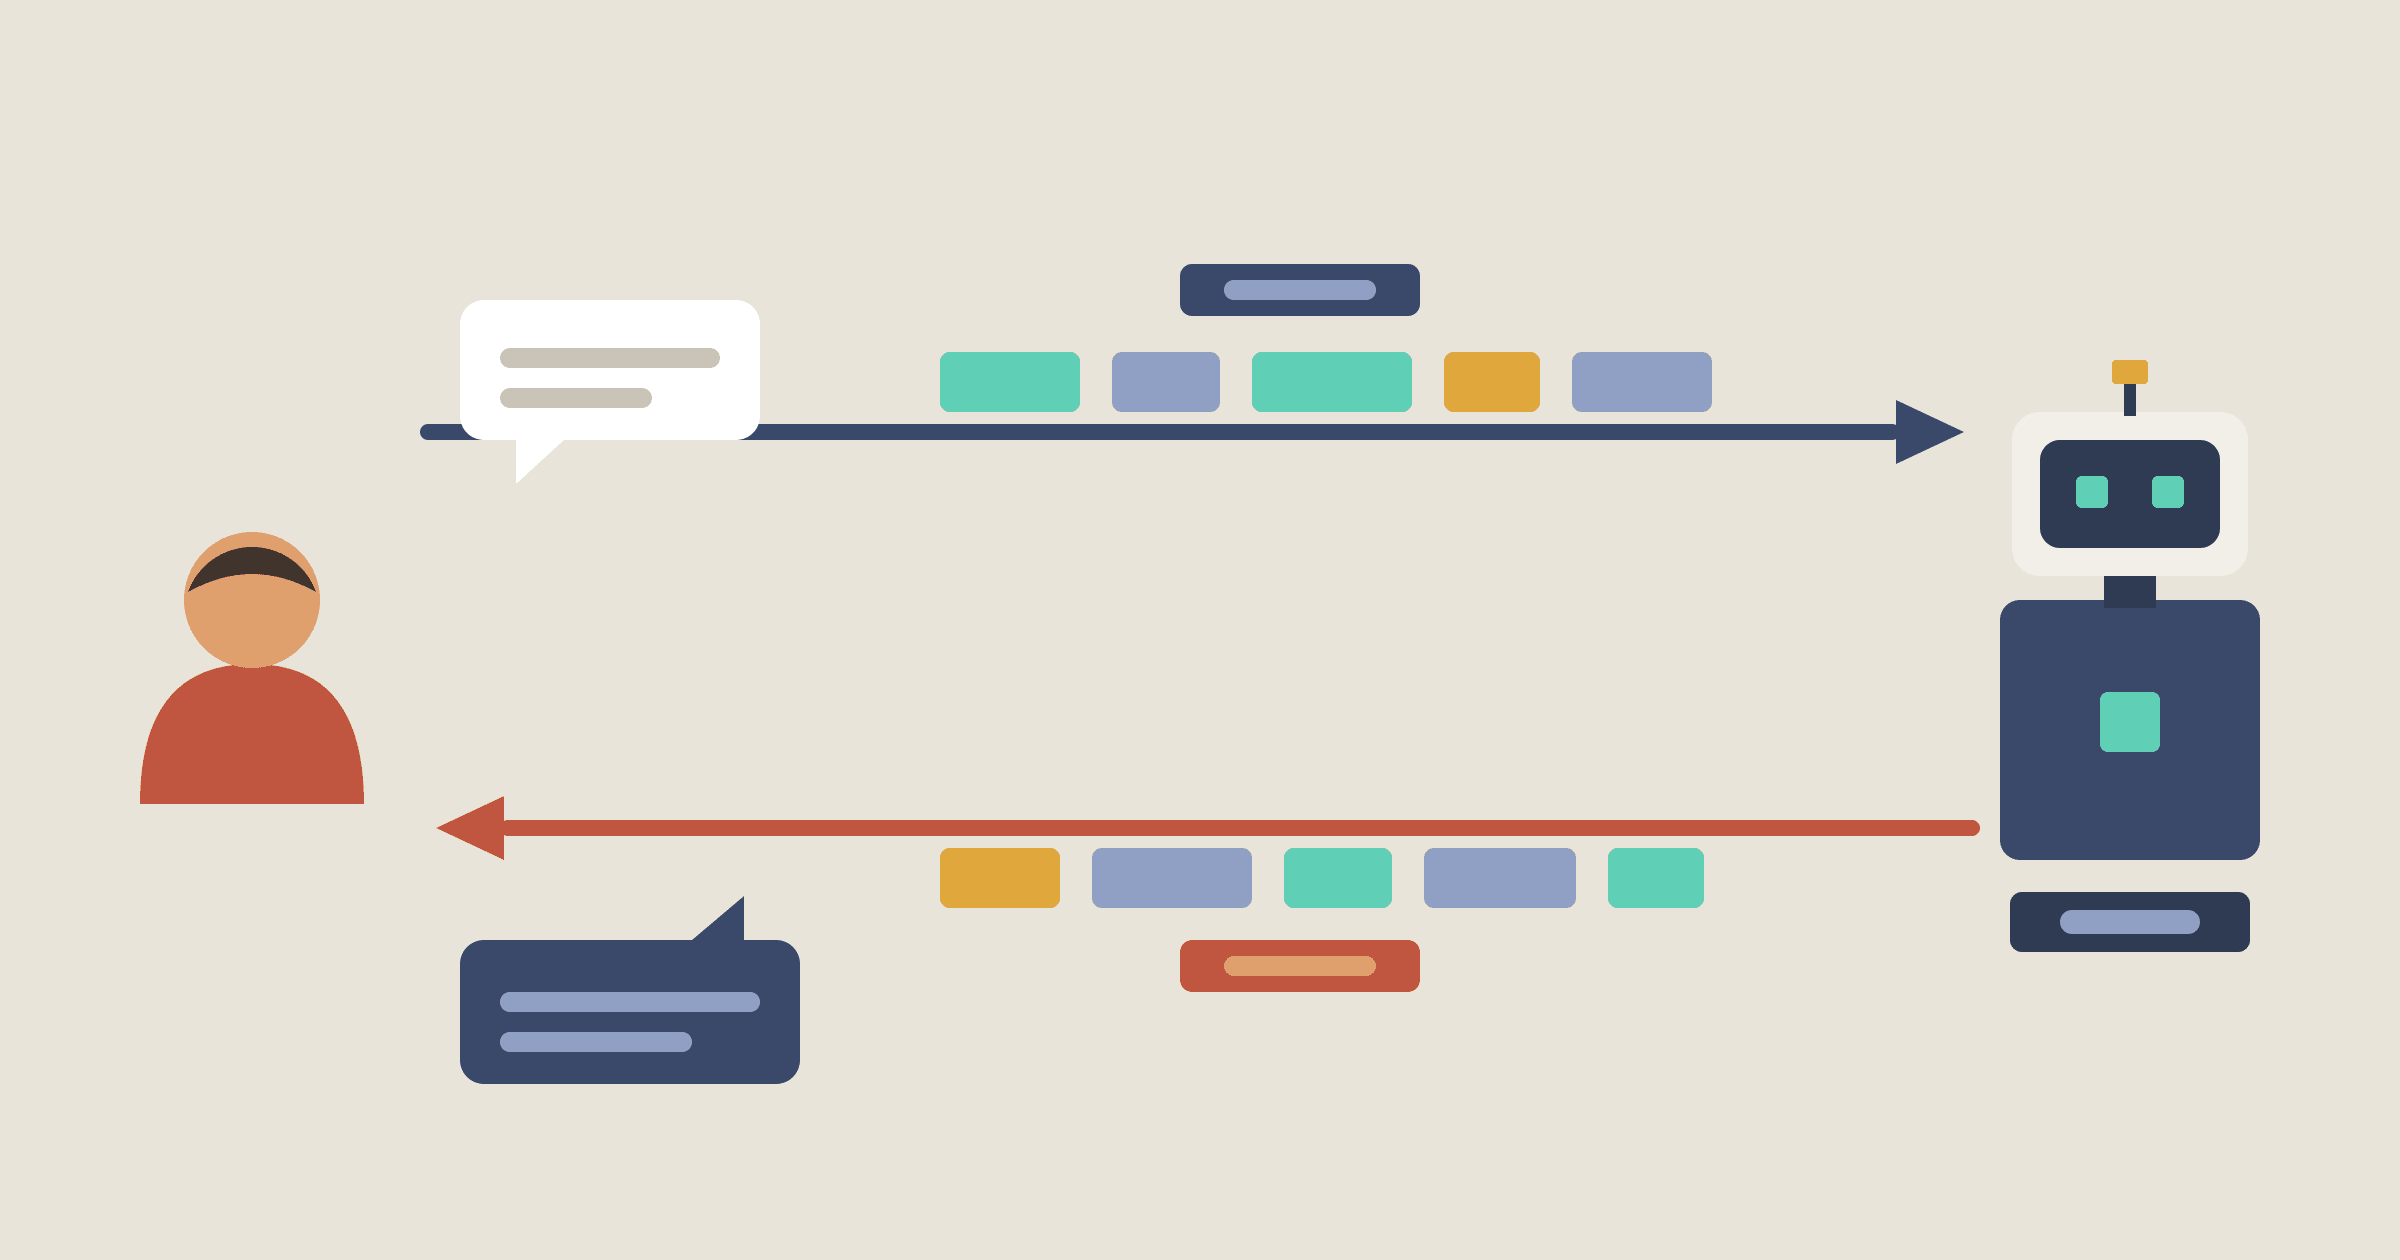
Zowel je vraag als het antwoord bestaat uit tokens. Allebei tellen mee.
Waarom dezelfde tekst per model verschilt
Omdat elk model een eigen tokenizer gebruikt. Dat is het stuk software dat tekst opknipt, en elke tokenizer doet dat op zijn eigen manier. Dezelfde zin wordt bij GPT, Llama, Qwen of Gemini dus in een ander aantal tokens verdeeld.
Twee dingen om te onthouden:
- Ongewone woorden worden vaker opgeknipt. Bekende woorden blijven meestal heel, zeldzame worden in meer stukjes verdeeld.
- Niet-Engelse tekst kost bij veel tokenizers meer tokens. Veel modellen zijn vooral op Engelse tekst getraind, dus talen als het Nederlands worden vaak in kleinere stukjes gehakt. Dat is geen wet, maar het komt regelmatig voor.
Wanneer het je geld kost
Tokens zijn vooral relevant als je een AI via een API gebruikt, bijvoorbeeld als je software rechtstreeks met een model praat. Dan reken je meestal per token af, en vaak met twee tarieven:
- Wat je erin stopt (je vraag, plus alle context die je meestuurt).
- Wat de AI teruggeeft (het antwoord). Dit is vaak duurder.
Een paar actuele voorbeeldtarieven, per 1 miljoen tokens:
| Model | Input | Output |
|---|---|---|
| GPT-5.1 | $1,25 / 1M tokens | $10,00 / 1M tokens |
| Claude Opus 5.5 | $4,00 / 1M tokens | $20,00 / 1M tokens |
| Gemini 2.5 Flash | $0,30 / 1M tokens | $2,50 / 1M tokens |
| Mistral Large 3 | $0,50 / 1M tokens | $1,50 / 1M tokens |
Dit zijn API-prijzen van september 2026; aanbieders kunnen ze later wijzigen. Je ziet in elke rij dat output duurder is dan input.
Een simpel rekenvoorbeeld. Stel je gebruikt Gemini 2.5 Flash en verstuurt in totaal 1 miljoen inputtokens en ontvangt 1 miljoen outputtokens. Dan kost dat ongeveer $0,30 + $2,50 = $2,80.